
用 GitHub Actions 实现 CI/CD 自动部署
用 GitHub Actions 实现 CI/CD 自动部署
本文记录如何用 GitHub Actions 串起从代码推送到上线的流程:自动验证、构建、上传产物并更新服务,让生产服务器只负责运行,不再承担构建压力。
我为什么开始折腾 CI/CD
最开始,我的部署方式完全是手动的:本地写完代码,先推送到 GitHub,再通过 SSH 登录服务器,手动 git pull 拉取代码,执行 npm install 安装依赖,再用 npm run build 构建,最后更新线上服务。
但实际操作中,构建经常卡住,连带着 SSH 连接也会中断。我已经确认,原因就是服务器内存不足:服务器内存只有约 1.6 GiB,一边运行线上服务,一边执行构建,内存不够用。因此,需要把构建工作搬离服务器,让它只负责运行服务。
于是,我先想到一个办法:在本地构建好,再用 SCP 把产物上传到服务器,让服务器只负责运行。 这一步解决的是“在哪里构建”的问题,但构建、上传、更新版本这些操作,仍然需要我手动完成。
接着,我想到了以前一直听说、却从来没用过的 GitHub Actions:既然这些步骤每次都差不多,能不能让 GitHub 在收到代码后,自动替我执行?
我想达到的效果是:
本地修改代码,push 到 GitHub ↓GitHub Actions 自动验证和构建 ↓把构建产物上传到服务器 ↓服务器更新版本并检查服务是否正常所以,我学习 CI/CD 不是为了先记住一套概念,而是为了解决一个具体问题:从“SSH 登录服务器,手动拉代码、装依赖、构建”,变成“我只负责推送代码,流水线负责验证、构建和部署”。
这条思路分成两步就很清楚:先把构建搬离服务器,减轻服务器压力;再把重复的发布步骤交给 GitHub Actions,减少手动操作。

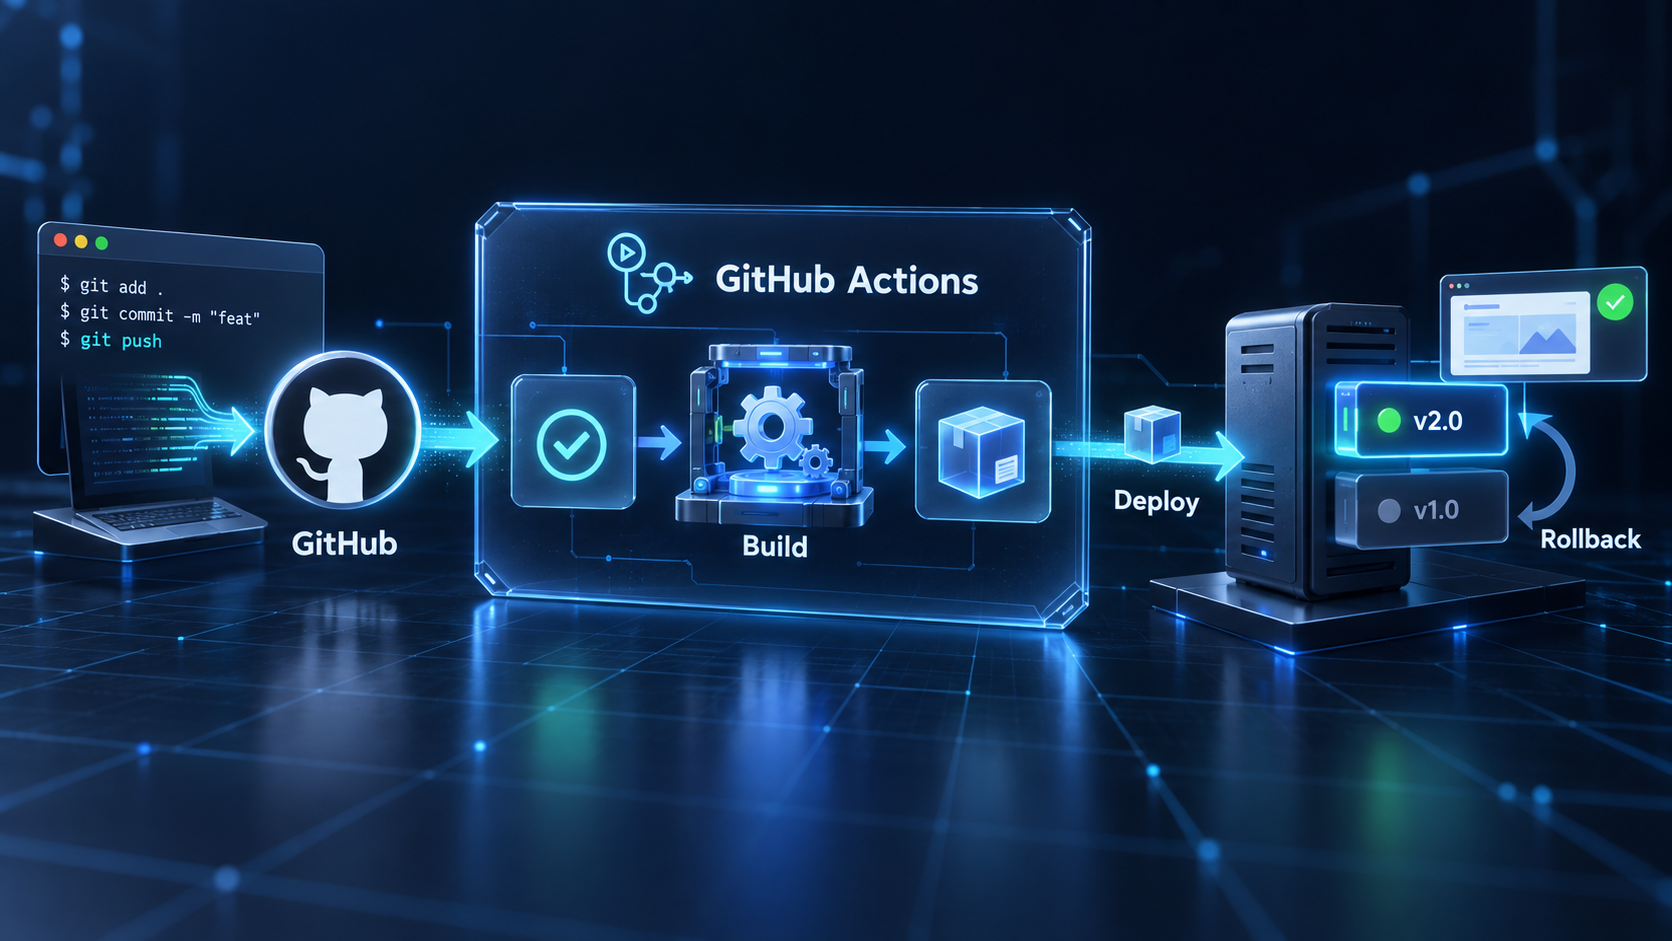
这张图展示从提交代码到上线的完整流程:push 后,GitHub Actions 自动验证、构建并打包,通过 SCP 上传产物,再通过 SSH 执行服务器上的版本切换和重启,最后做健康检查,失败时尝试回滚。核心是把构建交给 Actions,服务器只负责运行产物。
一、我的部署分工
最终采用的分工是:
本地电脑 └─ 写代码,git push
GitHub Actions runner ├─ 拉取代码 ├─ 安装依赖 ├─ 运行测试 ├─ 构建 Next.js standalone └─ 打包部署产物
生产服务器 ├─ 接收压缩包 ├─ 解压到 releases/<commit-sha> ├─ 切换 current 软链接 ├─ 重启 systemd 服务 └─ 做健康检查为了尽早发现代码问题、减少手动发布操作,我们把验证和部署组织成 CI/CD 流程:
- CI(Continuous Integration,持续集成):频繁地将代码变更集成到共享主干,并通过自动构建、测试等检查,尽早发现问题。本文中的安装依赖、测试和构建,就是其中的自动验证步骤。
- CD(Continuous Deployment,持续部署):本文采用这一含义,即在 CI 检查通过后,自动将构建产物部署到生产环境并更新服务,不需要人工批准上线。
这个项目推送到 master 后会自动验证、构建并部署,采用的就是持续集成 + 持续部署。GitHub Actions 是执行这套流程的工具,不是 CI/CD 本身。
二、从 push 到上线的主线
实际流程压缩起来就是这一条:

这张图按执行位置串起发布主线:本地 push 触发工作流,runner 负责验证、构建和打包,再通过 SCP 上传产物、SSH 执行服务器上的版本更新,健康检查通过后完成发布。

GitHub Actions 是 GitHub 提供的自动化工具:在 .github/workflows/ 中编写 workflow(工作流),由 on 指定 push 等触发事件。一个 workflow 包含一个或多个 job(任务),每个 job 由 **runner(执行机器)**执行,内部的 **step(步骤)**按顺序运行;step 用 run 执行命令,或用 uses 调用封装好的 action(操作)。不同 job 默认可并行,用 needs 指定先后依赖;runner 不等于生产服务器,远程部署需通过 SSH 等方式连接。
下面用项目中的几个配置项,看看这些概念在 YAML 中怎么写。以下是局部示例,不是完整的部署配置。
第一个例子:什么时候触发 workflow?
on: push: branches: [master] workflow_dispatch:on 指定整个 workflow 的触发条件:push 配合 branches: [master],表示向 master 推送代码时运行;workflow_dispatch 则允许在 GitHub 页面手动触发。这里决定的是“什么时候开始”,还没有描述具体做什么。
第二个例子:job 在哪里执行,step 做什么?
下面补出必要层级作示意,其他步骤省略:
jobs: build: runs-on: ubuntu-latest steps: - uses: actions/setup-node@v4 with: node-version: 22 cache: npm这里的 build 是 job 的标识,runs-on 为它选择 GitHub 提供的 Ubuntu 执行机器;steps 中的这个步骤通过 uses 调用 actions/setup-node,准备 Node.js 环境。with 是传给这个 action 的参数:使用 Node.js 22,并启用 npm 缓存来加快依赖准备,但缓存不能代替后续的 npm ci 安装步骤。注意,@v4 是 action 的版本,22 才是 Node.js 的版本。
Next.js 使用 standalone 输出:
output: 'standalone'standalone 的意义是:生产服务器不需要完整源码和完整 node_modules,主要运行构建后的:
.next/standalone/server.js这正好适合低内存服务器。
三、服务器上怎么切换版本
服务器不是直接覆盖旧目录,而是保留多个 release:

图中 incoming/ 暂存上传的包,releases/ 分别保存新旧版本,current 是指向所选版本的软链接,.env 则单独留在服务器。新版本先准备完整,再切换入口并重启服务,避免直接覆盖旧文件,也为失败回滚保留旧版本。
~/English_Context/├── incoming/├── releases/│ ├── <sha-1>/│ └── <sha-2>/├── current -> releases/<当前版本>└── .env每次新版本上传后,先解压到:
releases/<commit-sha>/然后把 current 软链接切过去:
ln -sfn "$release" "$next_link"mv -Tf "$next_link" "$current"这样做的好处是,服务目录要么指向完整旧版本,要么指向完整新版本,不会停在复制了一半的状态。
服务由用户级 systemd 运行:
WorkingDirectory=%h/English_Context/currentEnvironment=NODE_ENV=productionEnvironment=PORT=3456Environment=HOSTNAME=0.0.0.0ExecStart=/usr/bin/node server.jsRestart=on-failureRestartSec=5部署脚本切换 current 后,执行:
systemctl --user daemon-reloadsystemctl --user restart english-context.service最后用 curl 检查本机端口:
curl -fsS --max-time 2 "http://127.0.0.1:3456/"这个检查不代表业务完全正常,但至少能确认 Next.js 服务已经启动,并且 HTTP 能返回成功状态。
四、失败时怎么退回去
自动部署一定要考虑失败。这里最需要处理的是:文件已经上传了,current 也切到新版本了,但服务启动失败或健康检查失败。
脚本会在切换前记录旧版本:

沿着上排看:先记录旧版本,再切到新版本并重启,随后检查服务是否正常响应;如果检查失败,就沿虚线进入下排,把 current 切回旧目录并重启。回滚能成立,是因为旧版本仍被完整保留,而不是失败后再重新构建一次。
previous="$(readlink -f "$current")"如果新版本失败,就把 current 切回旧版本,并重启服务:
ln -sfn "$previous" "$next_link"mv -Tf "$next_link" "$current"systemctl --user restart "$unit_name"这只能回滚应用目录,不能回滚所有东西。数据库、用户数据、缓存、Service Worker 都可能有自己的状态。
五、数据库迁移单独处理
ContextVocab 使用 Prisma 和 PostgreSQL。应用发布和数据库结构变更不是一回事:

左边的应用版本可以通过 current 切回旧目录,右边的数据库变更却不会随之撤销:例如字段已经被删除,退回旧代码也无法把它恢复。因此,数据库迁移需要单独处理,优先做兼容新旧代码的渐进变更,不能把应用回滚当成数据库回滚。
应用代码发布数据库 schema/migration 发布当前 workflow 不自动执行数据库迁移。原因是:应用 release 可以切回去,但数据库迁移未必可逆。
生产数据库更适合渐进式处理:
1. 先添加兼容旧代码的新字段2. 部署兼容新旧结构的代码3. 执行数据回填或索引调整4. 验证生产读写5. 后续版本再删除旧字段这样新旧代码在过渡期都能工作,出问题时也更容易退回。
六、这套方案的核心
这篇记录里真正重要的不是 GitHub Actions 的 YAML 细节,而是这条分工:
本地负责写代码和推送GitHub Actions 负责验证和构建服务器负责运行产物和切换版本健康检查决定发布是否成功失败时回滚应用 release数据库迁移单独设计对低内存服务器来说,这比“SSH 上去现场构建”稳定很多。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
这篇文章对你有帮助吗?
正在加载点赞数…